低手
Monday, February 9, 2026 | 2 分钟
Yan:Foundational Interactive Video Generation
Abstract
Introduction
第一段主要说igv的应用和缺陷。aigc正在从生成文本和图像到视频合成(synthesis),现在在已经发展到交互视频生成(IGV)。IGV要求动态地对用户输入进行反应,应用范围从虚拟仿真到具身智能。但是当前方法的缺陷在于缺乏高视觉保真度(fidelity)、持续的时间连贯性(coherence)、丰富的交互性(interactivity)。生成的内容也在创建后保持静态,无法实时地适应。(不高清、不连贯、不交互)
第二段详细讲述现存方法的缺点。GameNGen、PlayGen、MineWorld的视频质量和泛化能力不行;The-Matrix、GameFactory、Matrix-Game缺乏复杂(intricate)的物理仿真,实时性也不好。最重要的是这些方法把交互视频当成固定的内容生成,不支持动态编辑。列出三个核心挑战:1. 高保真度的实时视觉体验;2. 泛化好,prompt可控的生成;3. 交互过程中动态、交互的编辑以及即时内容的定制
- 高保真(高分辨、细节真实感、时间连贯)的画面
- 实时:高帧率的情况下要迅速生成(Latency必须小);
- 泛化能力好
- on-the-fly:不停止运行,在执行的过程中修改
- 是能够实时editing的,可以切换风格并且可以交互
传统游戏是通过计算产生下一帧的,比如物理引擎用于计算角色在重力作用下会跳高多少cm;通过逻辑计算判断是否会掉下去或者撞墙;通过gpu进行渲染一个像素一个像素地画出画面
第三段讲述本文提出的YAN架构。基于的数据集是Yuan_Meng_Star。主要分为三个模块:
- AAA-level Simulation: 利用高压缩、低时延的3D-VAE,结合基于KV-cache的shift-window降噪推理过程,实现1080p/60fps性能
3D-VAE:视频压缩包,把高清画面压小,处理起来才快
KV-cache: 缓存之前“想过”的信息,只关注正在变化的小window
- Multi-modal Generation: 分层打标(hierarchical captioning),游戏特有知识注入到视频扩散模型
支持文本和图像的多模态
- Multi-granularity Editing: 混合架构显式地将交互力学模拟和视觉渲染解耦(disentangles),支持在任何时刻对视频进行编辑
解耦将玩家的操作动作和画面解耦开
Related-Work
Interactive Generative Video
先前的IGV工作主要分成两部分。第一种是基于游戏的IGV,它把在游戏数据集里学习到的动作控制和结构transfer到开放(open-ended)环境中,它在某些场景下表现出泛化能力,依赖动作标注。但是这一类不是真正逐帧(frame-wise)的交互式。
- 不逐帧: 成块控制的(chunked control),而不是逐帧生成的(每一帧画面基于上一帧画面和当前的动作信号),比如按下一个键执行这个动作的期间按其他键是不起作用的(动作指令被打包了)
- high latency: 高延迟,按下键后画面不会立刻反应(时间太长)
- 更注重navigation(导航)而缺乏精确的物理效果
- 画质不行
第二种是真实世界的世界模型。它可以在受控制的情况下预测未来的帧的内容,但是不是prompt controllable的也无法提供实时的动作响应。
- 无法即时控制
- 无法根据prompt修改内容
Game Simulation with Nerual Network
传统游戏是代码写死的,这一方面的研究是想让AI通过阅读大量视频学会游戏的逻辑。MarioVGG通过基于文本的action和游戏的第一帧生成游戏视频片段,但是不实时(生成速度比播放速度慢很多)。GameGen、PlayGen、Oasis用Diffusion实现20FPS的游戏模拟(分辨率和帧率都很低)。本作实现60FPS/1080P。
Video Editing
基于diffusion model的视频编辑可以保持时空相干性(spatiotemporal coherence)。但是问题是假设用户输入是非交互式的,不能保证生成的内容可以实时反应用户的操作。
时空相干性:视频改完后画面不能闪烁,物体形状不能崩塌。
过去的研究很多都集中在高画质上没有考虑实时编辑。YAN将机制模拟器和视觉渲染解耦(多粒度)。机制模拟器处理物理特性和交互性,文本提示的视觉渲染根据输入的文本处理风格。
Overview
数据集源于3d游戏环境中的自动采集的交互式视频数据集。系统是端到端的,分为三个模块。
Yan-Sim:3A级模拟
高画质、实时渲染和物理模拟
Yan-Gen: 多模态生成
prompt controllable并且可以通过文字或者图像生成视频
Yan-Edit: 多粒度编辑
把交互机制模拟和视觉渲染解耦(stucture and style)
Data Collection
讲述如何构建数据集(automated pipeline),对于三个模块的数据集是共享的。 数据集特殊在有per-frame interaction annotation(反映两帧之间的转换关系用来学习动作是如何改变帧的画面的)。
之前的工作使用的数据集场景太少并且物理规律比较简单。
Data Collection Pipeline
Exploration Agent
开发一种scene exploration agent自动和环境交互生成视频数据。
在每个时间步t,根据环境的图像状态ot采取动作at(交互标注)。交互策略由一个随机模型和一个近段策略优化(PPO)的RL模型组成来决定交互的动作,类似于PlayGen。
为什么要用混合模型?只用随机模型的话只能在场景初始位置的一个小范围里收集数据。通过RL模型,agent可以探索场景中的每个位置。
随机模型提供广度(breadth),RL模型提供深度(depth)。随机模型代表可以随机找位置跑,但是只能小范围内跑,不能跑远。
Collection of Image-Action Pair Sequence
agent会采集包括{ot,at}的对。序列对的精度很重要,动作要和那一帧的画面精确对齐,不能出现操作之后,记录1s之后的画面下来。本文通过时间戳来实现,因为画面渲染和指令交互是两个系统,给每一帧画面和每一个动作都打上timestamp,来拼接在一起。就是在agent执行的时候(精准的时间戳)进行截屏,同时把动作信号和对应的图像一起保存。
Data Filters
数据采集过程存在缺陷:设备限制导致渲染失败或者延迟;视角的变化导致部分数据被场景元素遮挡(白墙等);不符合交互机制的数据(穿模、按键没反应、不能操作的加载动画)
应用三层data filters
Visual Filter
用来过滤渲染失败和被遮挡的场景,即剔除无效画面。这类画面的特点是低颜色方差(白墙、黑屏)。
解决方法: 计算画面的平均颜色方差,和threshold比较,如果低于threshold就丢弃。
Anomaly Filter
识别视频卡顿(stuttering)。这类画面的特点是有过多的冗余帧(rebundant frame),帧数很高。
解决方法:同样设置一个threshold,移除帧数高于它的segment
Rule Filter
移除与交互规则不一样的数据(同一个场景下同一个动作应该产生相同的结果),这种不一致是游戏引擎导致的。比如准备画面,按键是没有用的。
没说怎么过滤的
Data Balancer
强偏置(bias)的数据会导致特定场景下模型的过拟合。举个例子,100个小时内95个小时机器人一直在平地跑,AI容易学习overfitting到平地场景,觉得任何时间都应该平地跑。 这里使用balanced sampling。除了记录image-action pair之外,还记录在t时刻的额外信息(坐标,只能替是否存活,是否发生碰撞等等),在这些属性上执行balanced sampling。
Balanced Transition Characteristics: 不同状态之间的转换,比如跑to掉下悬崖,跑to撞墙。原始数据里平常的状态转换(跑to跑)很多,做balanced sampling增加那些不寻常的状态转换的比例。
Uniform Positional Distribution: 地图里均匀的位置分布,通过xyz坐标进行balanced sampling
High-Quality Interactive Video Data
1080P High-Resolution Images
NVIDA 4060
30FPS High-Frame-Rate Videos
agent帧率太高,游戏引擎可能跟不上,会图像和动作对不上。逻辑处理和渲染处理是并行的,逻辑处理太快,渲染还没跟上会错位。通过动作插值(action interpolation)解决。agent一秒发出十个动作(10Hz),一秒截30次屏,利用时间戳对应上动作。
High-Precision Image-Action Pair Sequances
在t帧记录的动作,在接下来的1、2帧就会被捕捉
Diverse Action Space
除了上下左右、跳跃,还有俯冲(swooping——、左右旋转等动作)
Diverse Interactive Scenarios
3D游戏环境提供多个不同风格的场景
Data Summary
采集超过4亿帧交互视频数据,超过90种场景
Methods
Yan-Sim
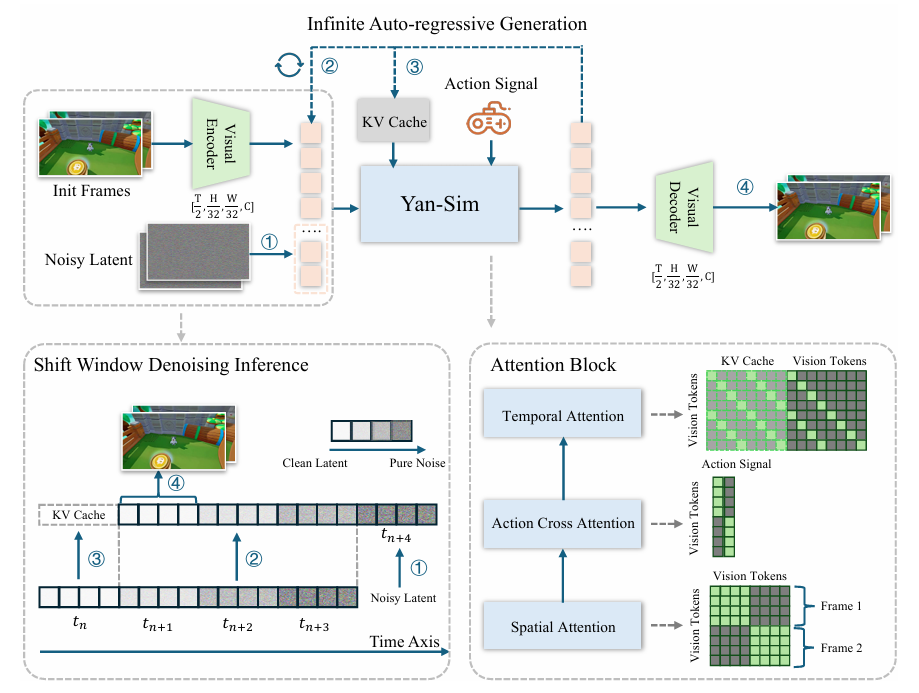 高画质、低时延、高FPS
Model Architecture
基础模型为Stable Diffusion。进行了三方面的改进:1. 提高VAE地压缩率 2. 让扩散过程适应实时交互推理 3. 轻量级结构修改和推理时间优化
VAE Design
VAE用于提纯,把像素点变成包含关键信息的数学特征(Latent Representation),把不重要的冗余删掉。
在VAE的编码器增加两个单层下采样模块(down blocks)来增强空间压缩,把下采样因子(downsampling factor)从8提高到32(像素点减少4*4=16倍)
连续的视频帧沿通道维度进行拼接,实现为2的时间下采样。
通道拼接:RGB三通道,把当前帧和下一帧叠在一起,变成6通道的输入。长度为2意味着一次性吃两帧下去。
总的下采样率从1 * 8 * 8到2 * 32 * 32。这样的压缩需要每个latent token有更高的信息密度。 从空间上高度宽度各压缩了四倍(相当于4*4的信息,现在只能放到1个里面存储),所以把每个的通道数(Channel)提高到16。temporal压缩2倍。
推理过程中仅考虑解码器的模型延迟,decoder轻量化。首先在解码器的每一个up block里剪掉一层,然后添加一个single-layer up block和一个pixel-shuffle layer。
Diffusion Model Design
自回归的逐帧推理模式。
有三种attention模块。
Spatial attention:同一帧不同位置的token之间的关系
Action cross attention:用mlp给每一帧生成768的token,每个token只关注对应帧
1D temporal attention:用于解决帧间的依赖性。来自 $F_{t}$ 帧的token只能关注来自当前及之前帧 $F_{\le t}$ 的token
Yan的因果框架与bidirectional(需要知道开头和结尾,生成的长度是死的)不一样
Training
训练分为两步:VAE和Diffusion Model
VAE Training
沿通道拼接的两帧$x \in \mathbb{R}^{H \times W \times 6}$,通过encoder之后变成一个latent $z \in \mathbb{R}^{h \times w \times 16}$ h和w为原尺寸的1/32
损失函数:MSE和Learned Perceptual Image Patch Similarity(LPIPS)的组合函数
VAE LPIPS?
Diffusion Model Training
遵循Stable Diffusion的框架,使用DDPM范式进行训练。把干净的latent逐步弄脏(加噪),然后让扩散模型去预测这些被添加的噪声。
Stable Diffusion和Diffusion的区别? DDPM?
用Diffusion Forcing策略对每一帧的latent representation独立添加噪声。第一帧作为conditioning signal不添加噪声。随着时间增长,噪声等级不断增大。
传统扩散模型尝试从全噪声中还原出一张图,而autoregressive代表第二帧的生成要依赖于第一帧。
Inference
主要目标是最小化延迟和最大化吞吐量。
使用DDIM采样器,把去噪步数减少到4步。
给定初始帧,经过VAE压缩到latent space
初始lantent和一个nosiy latent拼接。
扩散模型对noisy latent进行去噪,然后得到和动作对应的下一帧的干净latent
VAE把latent解码生成下一帧画面
Shift Window Denosing Inference
传统的去噪方法对每个样本要多次迭代,等迭代完基本就超时。
shift window denoising同时处理一小段连续的帧。窗口中每一帧的噪声水平不同,越早的帧越干净。每一步,一个pure noisy latent会被拼接到input latent上。每个推理步骤会生成一个干净的latent,然后解码成一个rgb图片。用KV caching存储历史的状态,可以避免冗余的计算。
什么是kv caching?
这一步可以降低生成每一帧的平均latency。
Pruning & Quantization
对UNet应用结构化剪枝,并把GEMM的权重和激活值量化为FP8。
CPU Graph & Triton (没懂)
Evaluation
视觉质量、运动一致性、世界物理、长视频生成能力
Visual Quality
reproduce不同的艺术风格
Motion Consistency
对输入动作做出正确的反馈
Accurate Mechanbism Simulation
物理特性
Long Video Generation Capability
视频长时间稳定,飘逸drift小
Yan-Gen
四阶段训练
hierarchical captioning system提供稳定的全局上下文和详细的局部描述
在ODE轨迹上进行训练
ODE是什么?
Hierarchical Captioning for World and Local Context Modeling
核心问题是anti-drifting,用静态的全局环境和其中发生的动态局部事件分分别处理
Global Captioning: Defining the Static World
基于环境遍历视频(一分钟),生成一个单一的全局描述。这个全局的世界模型是constant的。
- 反映区域之间的联系
- 视觉主题(美学特征)
- 基础光影和天气
Local Captioning: Grounding Dynamic Events
对每一个视频clip(三秒钟)生成一个局部的描述(比如人物的动作)
要有时效性
local scene:紧邻的周围环境,依赖camera视角
interactive objects:状态发生明显变化的物体
critical events:角色死亡或者任务完成 (描述发生了什么事情)