Author Image

哈咯,我是 低手

低手

硕士研究生 at 英属哥伦比亚大学

我目前就读于不列颠哥伦比亚大学(UBC)温哥华校区电子与计算机工程系,攻读工学硕士学位。我对人工智能开发领域深感兴趣,尤其专注于视觉语言模型和扩散语言模型的研究。

Hard Working
Team Work
Innovation

技能

工作经历

1
华为技术有限公司

7月 2025年 - 12月 2025年

江苏南京

华为是全球领先的信息与通信技术(ICT)基础设施和智能设备供应商。

AI软件工程师实习

7月 2025年 - 12月 2025年

职责:
  • 参与面向 IDE 续写场景的 Java 代码大模型研发
  • 负责模型 SFT 阶段的数据流构建以及 DPO 阶段基于线上真实 Badcase 的偏好对齐优化,实现模型离线准确率与线上真实采纳率的双重提升。

教育经历

工学硕士,电子与计算机工程
GPA: 92.9 / 100
理学学士,计算机科学
GPA: 3.86 / 4
工学学士,软件工程
GPA: 86.7 / 100

精选博文

Hero Image
Encoder-only

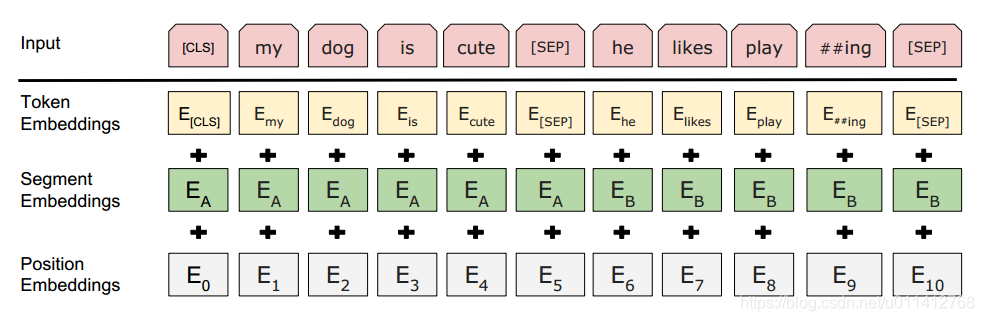
什么是预训练 通过自监督(无标注)来初始化神经网络模型参数 学习一种通用的语言理解能力 BERT BERT的预训练任务 Masked Language Modeling 将输入序列中的一部分(15%)token替换掉,然后去预测,让模型去预测这些词是什么。 8-1-1 80%的词被设为[MASK]:完形填空,能联系上下文的双向语义 10%被替换为词表中的任意随机token:模型不知道哪些是随机的,可以提高模型的纠错能力。逼迫模型联系全局语境,根据语境生成预测的词向量。 10%保持原始token不变:把模型对词的表征拉向真实的表征 优化目标 $$\mathcal{L}{MLM} = - \sum{i \in m} \log P(x_i | \tilde{X}; \theta)$$ 输入的损坏序列为 $\tilde{X}$,被选中的掩码位置集合为 $m$,$\theta$ 为模型参数 模型预测出第 $i$ 个位置真实单词 $x_i$ 的概率 $P$ 越大,取对数后再加负号得到的损失值 $\mathcal{L}$ 就越小 也就是说:虽然模型在顶层其实会输出句子中每一个词的预测结果(包括那 85% 没有被选中的正常词),但系统在计算 Loss 时,只挑出那 15% 被选中(无论是变 [MASK]、变随机词还是保持原词)的位置进行计算。 剩下 85% 位置的输出会被直接无视,不参与打分。 Next Sentence Prediction 随机抽取句子对(A,B),判断B是不是A的后续句子。增强跨句子理解的能力 50%真组合,50%假组合 [CLS] + A + [SEP] + B + [SEP] [CLS]分类符,放在序列首位判断是不是next [SEP]分隔符,分割两个句子 优化目标 $$\mathcal{L}_{NSP} = - \left[ y \log \hat{y} + (1-y) \log (1-\hat{y}) \right]$$

    Hero Image
    Yan:Foundational Interactive Video Generation

    Abstract Introduction 第一段主要说igv的应用和缺陷。aigc正在从生成文本和图像到视频合成(synthesis),现在在已经发展到交互视频生成(IGV)。IGV要求动态地对用户输入进行反应,应用范围从虚拟仿真到具身智能。但是当前方法的缺陷在于缺乏高视觉保真度(fidelity)、持续的时间连贯性(coherence)、丰富的交互性(interactivity)。生成的内容也在创建后保持静态,无法实时地适应。(不高清、不连贯、不交互) 第二段详细讲述现存方法的缺点。GameNGen、PlayGen、MineWorld的视频质量和泛化能力不行;The-Matrix、GameFactory、Matrix-Game缺乏复杂(intricate)的物理仿真,实时性也不好。最重要的是这些方法把交互视频当成固定的内容生成,不支持动态编辑。列出三个核心挑战:1. 高保真度的实时视觉体验;2. 泛化好,prompt可控的生成;3. 交互过程中动态、交互的编辑以及即时内容的定制 高保真(高分辨、细节真实感、时间连贯)的画面 实时:高帧率的情况下要迅速生成(Latency必须小); 泛化能力好 on-the-fly:不停止运行,在执行的过程中修改 是能够实时editing的,可以切换风格并且可以交互 传统游戏是通过计算产生下一帧的,比如物理引擎用于计算角色在重力作用下会跳高多少cm;通过逻辑计算判断是否会掉下去或者撞墙;通过gpu进行渲染一个像素一个像素地画出画面 第三段讲述本文提出的YAN架构。基于的数据集是Yuan_Meng_Star。主要分为三个模块: AAA-level Simulation: 利用高压缩、低时延的3D-VAE,结合基于KV-cache的shift-window降噪推理过程,实现1080p/60fps性能 3D-VAE:视频压缩包,把高清画面压小,处理起来才快 KV-cache: 缓存之前“想过”的信息,只关注正在变化的小window Multi-modal Generation: 分层打标(hierarchical captioning),游戏特有知识注入到视频扩散模型 支持文本和图像的多模态 Multi-granularity Editing: 混合架构显式地将交互力学模拟和视觉渲染解耦(disentangles),支持在任何时刻对视频进行编辑 解耦将玩家的操作动作和画面解耦开 Related-Work Interactive Generative Video 先前的IGV工作主要分成两部分。第一种是基于游戏的IGV,它把在游戏数据集里学习到的动作控制和结构transfer到开放(open-ended)环境中,它在某些场景下表现出泛化能力,依赖动作标注。但是这一类不是真正逐帧(frame-wise)的交互式。 不逐帧: 成块控制的(chunked control),而不是逐帧生成的(每一帧画面基于上一帧画面和当前的动作信号),比如按下一个键执行这个动作的期间按其他键是不起作用的(动作指令被打包了) high latency: 高延迟,按下键后画面不会立刻反应(时间太长) 更注重navigation(导航)而缺乏精确的物理效果 画质不行 第二种是真实世界的世界模型。它可以在受控制的情况下预测未来的帧的内容,但是不是prompt controllable的也无法提供实时的动作响应。 无法即时控制 无法根据prompt修改内容 Game Simulation with Nerual Network 传统游戏是代码写死的,这一方面的研究是想让AI通过阅读大量视频学会游戏的逻辑。MarioVGG通过基于文本的action和游戏的第一帧生成游戏视频片段,但是不实时(生成速度比播放速度慢很多)。GameGen、PlayGen、Oasis用Diffusion实现20FPS的游戏模拟(分辨率和帧率都很低)。本作实现60FPS/1080P。 Video Editing 基于diffusion model的视频编辑可以保持时空相干性(spatiotemporal coherence)。但是问题是假设用户输入是非交互式的,不能保证生成的内容可以实时反应用户的操作。 时空相干性:视频改完后画面不能闪烁,物体形状不能崩塌。 过去的研究很多都集中在高画质上没有考虑实时编辑。YAN将机制模拟器和视觉渲染解耦(多粒度)。机制模拟器处理物理特性和交互性,文本提示的视觉渲染根据输入的文本处理风格。 Overview 数据集源于3d游戏环境中的自动采集的交互式视频数据集。系统是端到端的,分为三个模块。 Yan-Sim:3A级模拟 高画质、实时渲染和物理模拟 Yan-Gen: 多模态生成 prompt controllable并且可以通过文字或者图像生成视频 Yan-Edit: 多粒度编辑 把交互机制模拟和视觉渲染解耦(stucture and style)

      最新博文

      Hero Image
      Diffusion LLM paper reading

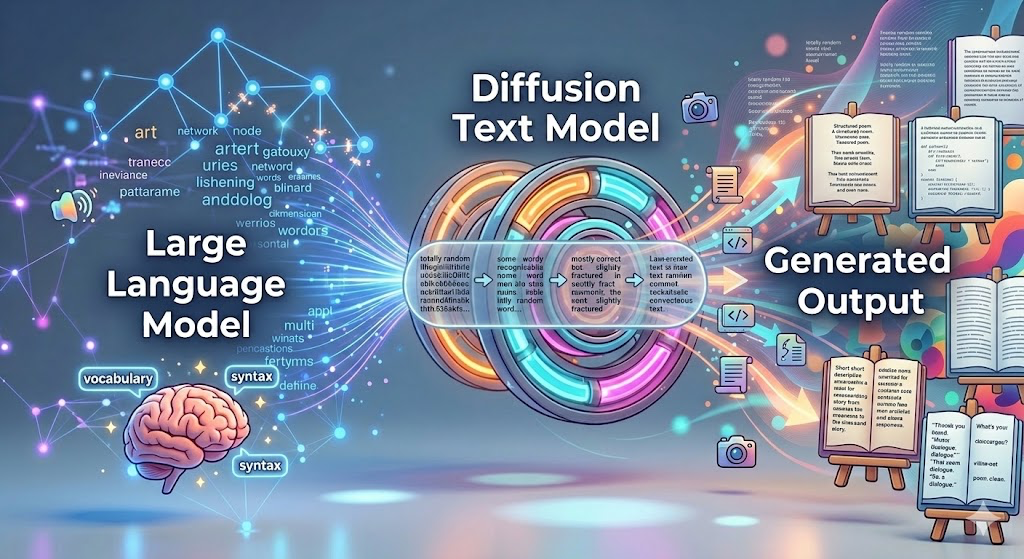
      1 Residual Context Diffusion Language Models 方法 传统dLLM在每轮预测的时候会把没有预测到的位置上的[MASK]直接扔掉,重置为新的空白[MASK];为了不浪费算力,会选择保留这些废弃的语义,转变成向量用于下一轮预测 算法 将模型预测的概率与词向量进行加权求和,生成残差向量: $ \Delta_i^{(t_k)} = \sum_{j=1}^V p_{i,j}^{(t_k)} E_{j,:} $ $E_{j}$是该词的词向量 残差向量的权重,来判断这个向量值不值得保留 $\alpha_i^{(t_k)} = \frac{-\sum_{j=1}^V p_{i,j}^{(t_k)} \log p_{i,j}^{(t_k)}}{\log V}$ $\alpha$越大,模型对这个词可能越没把握,越应该保留;如果有把握的词都没有被预测,说明可能不应该继续保留 $logV$用来把$\alpha$压缩到0-1之间 如果位置i的词没有被预测出来,就做残差相加,把残差项加到[MASK]上 如果已经被预测出来了,就是等于该词的词向量 $\tilde{e}i^{(t_k)} = \begin{cases} (1 - \alpha_i^{(t{k-1})})E(x_i^{(t_k)}) + \alpha_i^{(t_{k-1})}\Delta_i^{(t_{k-1})}, & \text{if } x_i^{(t_k)} = \text{[MASK]} \ E(x_i^{(t_k)}), & \text{otherwise} \end{cases}$ 训练 1 Reference Model Initialization 训练一个$\mathcal{M}_{ref}$,冻结所有参数,用来输出 $p^{(t)}$ 2 Residual-Aware Target Training 训练一个$\mathcal{M}_{target}$,输入为一个带[MASK]的句子 通过$\mathcal{M}_{ref}$算出来的概率,算出残差向量的权重$\alpha$ $ \Delta_i^{(t_k)} = \sum_{j=1}^V p_{i,j}^{(t_k)} E_{j,:} $ 计算词向量,概率由 $\mathcal{M}{ref}$ 得到,词向量来自$\mathcal{M}{target}$ 计算最终的加权结果作为输入 输入到$\mathcal{M}{target}$,预测无掩码的原句 损失函数:$\mathcal{L} = \mathbb{E}\left[\frac{1}{t}\sum{i:m_i=1} -\log P_{\theta_{target}}(x_i^{(0)} | {e_{i’}^{(t)}}_{i’=1}^b)\right]$ 推理 1 Warm-Start $\mathcal{M}_{ref}$输出第一步的概率分布$p^{(t_0)}$
        Hero Image
        Encoder-only

        什么是预训练 通过自监督(无标注)来初始化神经网络模型参数 学习一种通用的语言理解能力 BERT BERT的预训练任务 Masked Language Modeling 将输入序列中的一部分(15%)token替换掉,然后去预测,让模型去预测这些词是什么。 8-1-1 80%的词被设为[MASK]:完形填空,能联系上下文的双向语义 10%被替换为词表中的任意随机token:模型不知道哪些是随机的,可以提高模型的纠错能力。逼迫模型联系全局语境,根据语境生成预测的词向量。 10%保持原始token不变:把模型对词的表征拉向真实的表征 优化目标 $$\mathcal{L}{MLM} = - \sum{i \in m} \log P(x_i | \tilde{X}; \theta)$$ 输入的损坏序列为 $\tilde{X}$,被选中的掩码位置集合为 $m$,$\theta$ 为模型参数 模型预测出第 $i$ 个位置真实单词 $x_i$ 的概率 $P$ 越大,取对数后再加负号得到的损失值 $\mathcal{L}$ 就越小 也就是说:虽然模型在顶层其实会输出句子中每一个词的预测结果(包括那 85% 没有被选中的正常词),但系统在计算 Loss 时,只挑出那 15% 被选中(无论是变 [MASK]、变随机词还是保持原词)的位置进行计算。 剩下 85% 位置的输出会被直接无视,不参与打分。 Next Sentence Prediction 随机抽取句子对(A,B),判断B是不是A的后续句子。增强跨句子理解的能力 50%真组合,50%假组合 [CLS] + A + [SEP] + B + [SEP] [CLS]分类符,放在序列首位判断是不是next [SEP]分隔符,分割两个句子 优化目标 $$\mathcal{L}_{NSP} = - \left[ y \log \hat{y} + (1-y) \log (1-\hat{y}) \right]$$

          Hero Image
          Yan:Foundational Interactive Video Generation

          Abstract Introduction 第一段主要说igv的应用和缺陷。aigc正在从生成文本和图像到视频合成(synthesis),现在在已经发展到交互视频生成(IGV)。IGV要求动态地对用户输入进行反应,应用范围从虚拟仿真到具身智能。但是当前方法的缺陷在于缺乏高视觉保真度(fidelity)、持续的时间连贯性(coherence)、丰富的交互性(interactivity)。生成的内容也在创建后保持静态,无法实时地适应。(不高清、不连贯、不交互) 第二段详细讲述现存方法的缺点。GameNGen、PlayGen、MineWorld的视频质量和泛化能力不行;The-Matrix、GameFactory、Matrix-Game缺乏复杂(intricate)的物理仿真,实时性也不好。最重要的是这些方法把交互视频当成固定的内容生成,不支持动态编辑。列出三个核心挑战:1. 高保真度的实时视觉体验;2. 泛化好,prompt可控的生成;3. 交互过程中动态、交互的编辑以及即时内容的定制 高保真(高分辨、细节真实感、时间连贯)的画面 实时:高帧率的情况下要迅速生成(Latency必须小); 泛化能力好 on-the-fly:不停止运行,在执行的过程中修改 是能够实时editing的,可以切换风格并且可以交互 传统游戏是通过计算产生下一帧的,比如物理引擎用于计算角色在重力作用下会跳高多少cm;通过逻辑计算判断是否会掉下去或者撞墙;通过gpu进行渲染一个像素一个像素地画出画面 第三段讲述本文提出的YAN架构。基于的数据集是Yuan_Meng_Star。主要分为三个模块: AAA-level Simulation: 利用高压缩、低时延的3D-VAE,结合基于KV-cache的shift-window降噪推理过程,实现1080p/60fps性能 3D-VAE:视频压缩包,把高清画面压小,处理起来才快 KV-cache: 缓存之前“想过”的信息,只关注正在变化的小window Multi-modal Generation: 分层打标(hierarchical captioning),游戏特有知识注入到视频扩散模型 支持文本和图像的多模态 Multi-granularity Editing: 混合架构显式地将交互力学模拟和视觉渲染解耦(disentangles),支持在任何时刻对视频进行编辑 解耦将玩家的操作动作和画面解耦开 Related-Work Interactive Generative Video 先前的IGV工作主要分成两部分。第一种是基于游戏的IGV,它把在游戏数据集里学习到的动作控制和结构transfer到开放(open-ended)环境中,它在某些场景下表现出泛化能力,依赖动作标注。但是这一类不是真正逐帧(frame-wise)的交互式。 不逐帧: 成块控制的(chunked control),而不是逐帧生成的(每一帧画面基于上一帧画面和当前的动作信号),比如按下一个键执行这个动作的期间按其他键是不起作用的(动作指令被打包了) high latency: 高延迟,按下键后画面不会立刻反应(时间太长) 更注重navigation(导航)而缺乏精确的物理效果 画质不行 第二种是真实世界的世界模型。它可以在受控制的情况下预测未来的帧的内容,但是不是prompt controllable的也无法提供实时的动作响应。 无法即时控制 无法根据prompt修改内容 Game Simulation with Nerual Network 传统游戏是代码写死的,这一方面的研究是想让AI通过阅读大量视频学会游戏的逻辑。MarioVGG通过基于文本的action和游戏的第一帧生成游戏视频片段,但是不实时(生成速度比播放速度慢很多)。GameGen、PlayGen、Oasis用Diffusion实现20FPS的游戏模拟(分辨率和帧率都很低)。本作实现60FPS/1080P。 Video Editing 基于diffusion model的视频编辑可以保持时空相干性(spatiotemporal coherence)。但是问题是假设用户输入是非交互式的,不能保证生成的内容可以实时反应用户的操作。 时空相干性:视频改完后画面不能闪烁,物体形状不能崩塌。 过去的研究很多都集中在高画质上没有考虑实时编辑。YAN将机制模拟器和视觉渲染解耦(多粒度)。机制模拟器处理物理特性和交互性,文本提示的视觉渲染根据输入的文本处理风格。 Overview 数据集源于3d游戏环境中的自动采集的交互式视频数据集。系统是端到端的,分为三个模块。 Yan-Sim:3A级模拟 高画质、实时渲染和物理模拟 Yan-Gen: 多模态生成 prompt controllable并且可以通过文字或者图像生成视频 Yan-Edit: 多粒度编辑 把交互机制模拟和视觉渲染解耦(stucture and style)